你的 Vibe Coding,为什么总有点像 DEMO
概要
我用同一批数据、同一个模型,主要改变 Prompt,看看哪些判断还没有发生,以及 Agent 的价值可能在哪里。
一次个人实践观察:使用虚构数据做对照,未做真实用户测试。
有些 Vibe Coding 做出来的页面,我第一眼看过去会有一种很主观的感觉:功能都有,但还是有点像 DEMO。
不是不能用,也不一定难看。单独看每个部分,也都挺合理。可整体放在一起,就是有一点 DEMO 感。
这种感觉,到底从哪里来?
我先怀疑过几个方向
我一开始其实也不确定,是哪一层在起作用。
也许是视觉完成度:间距、字体、颜色、状态这些细节还不够,所以显得像 DEMO。
也许是信息层级:每个模块都差不多重要,用户不知道第一眼该看哪里。
也许是更上游的产品判断:页面只是把需求里的功能都摆了出来,却没有回答,谁在用、为什么此刻打开、现在最需要判断什么、哪些信息可以弱化或删掉。
三个我都说得出道理。
我想自己试一次
如果真正的差别不在 polish,而在前面的判断有没有发生,我想自己试一次。
我虚构了一个客服系统 Relay,页面是客服主管早上打开的总览。同一个产品、同一批数据、同一个模型,每一版都在全新、互相看不到的上下文里生成。主要改变的,是 Prompt:
A:告诉 Agent 页面要有什么。
B:告诉 Agent 用户现在需要判断什么。
Prompt A
Build a modern, clean, production-ready support dashboard page for “Relay”…
为 Relay 做一个现代、干净、可用于正式环境的客服 Dashboard 页面……
后面列了十个模块:KPI、趋势、容量预测、SLA 工单、最近工单……这是一个很正常的功能需求,我没有故意把它写差。
Prompt B
Nadia is the support shift lead. It is Monday 9:05 AM… she has about ten minutes before the 9:30 standup, and the busy US East Coast hours start at 10:00.
Nadia 是客服值班主管。现在是周一早上 9:05……离 9:30 的晨会只剩大约十分钟,而美东的忙碌时段从 10:00 开始。
…is the team about to fall behind in a way that will hurt customers, what is driving it, and what should she do first.
……团队是不是快要落后到会影响客户?原因是什么?她应该先做什么?
Structure the page from her task, not from a typical dashboard template.
页面结构要从她的任务出发,而不是照搬典型的 Dashboard 模板。
B 没有模块清单,也没有说什么放哪里。只说了她是谁、为什么此刻打开、要判断什么,并允许把信息合并、弱化或省略。
数据里藏着一件事:周五发版以后,SSO 登录问题暴增。两个 Prompt 都没有说它重要。
第一版:告诉它“页面要有什么”
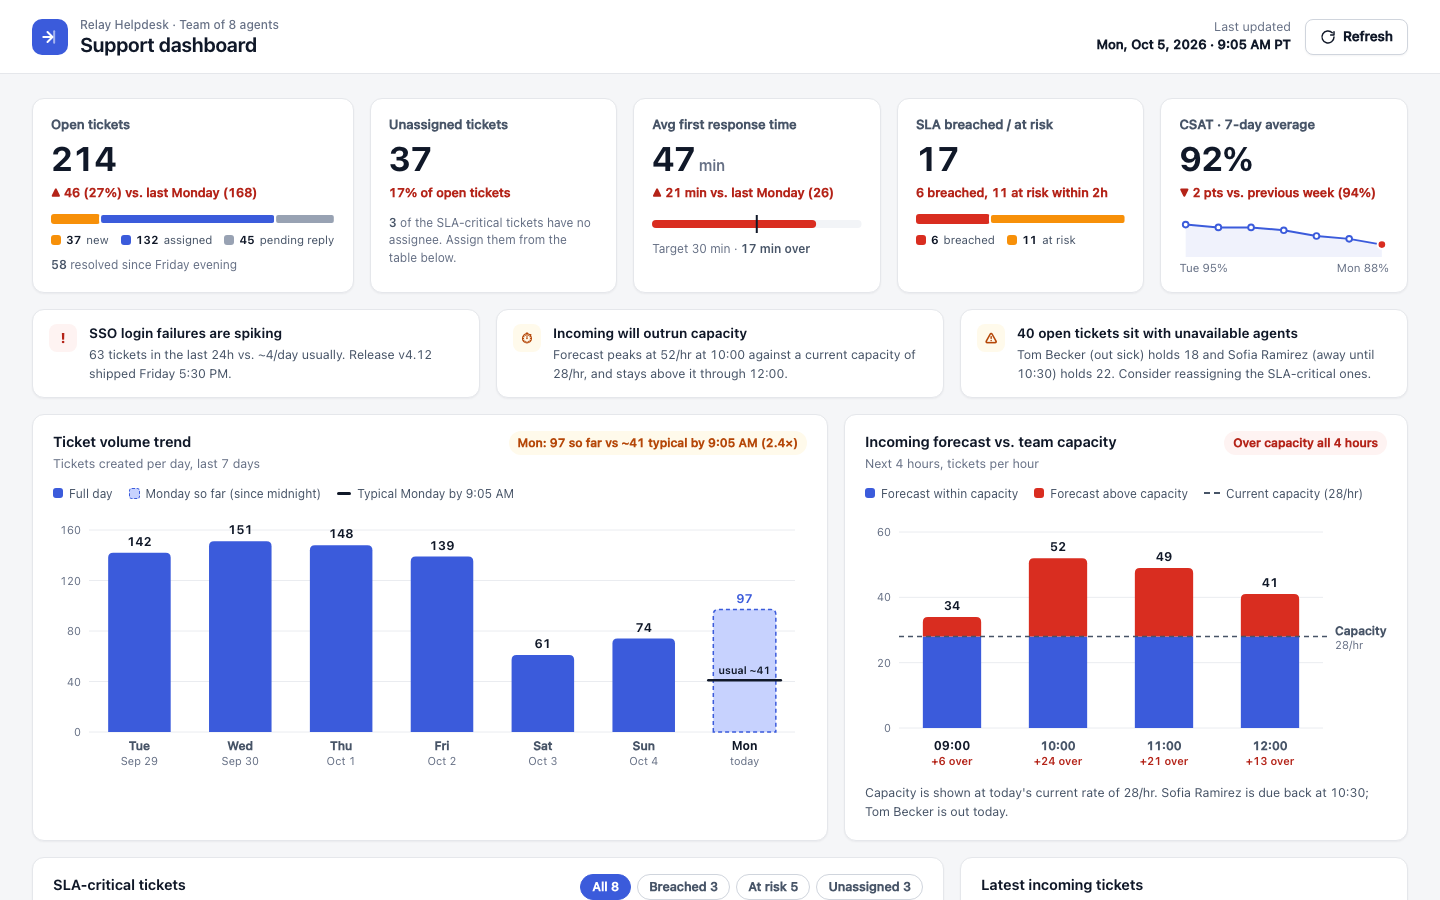
它其实做得不差。
KPI 有,提示有,趋势有,SLA 表有,最近工单也有。没有明显的设计错误。
但如果我是 Nadia,我现在到底该先看什么、先做什么?
第二版:告诉它“用户现在需要判断什么”
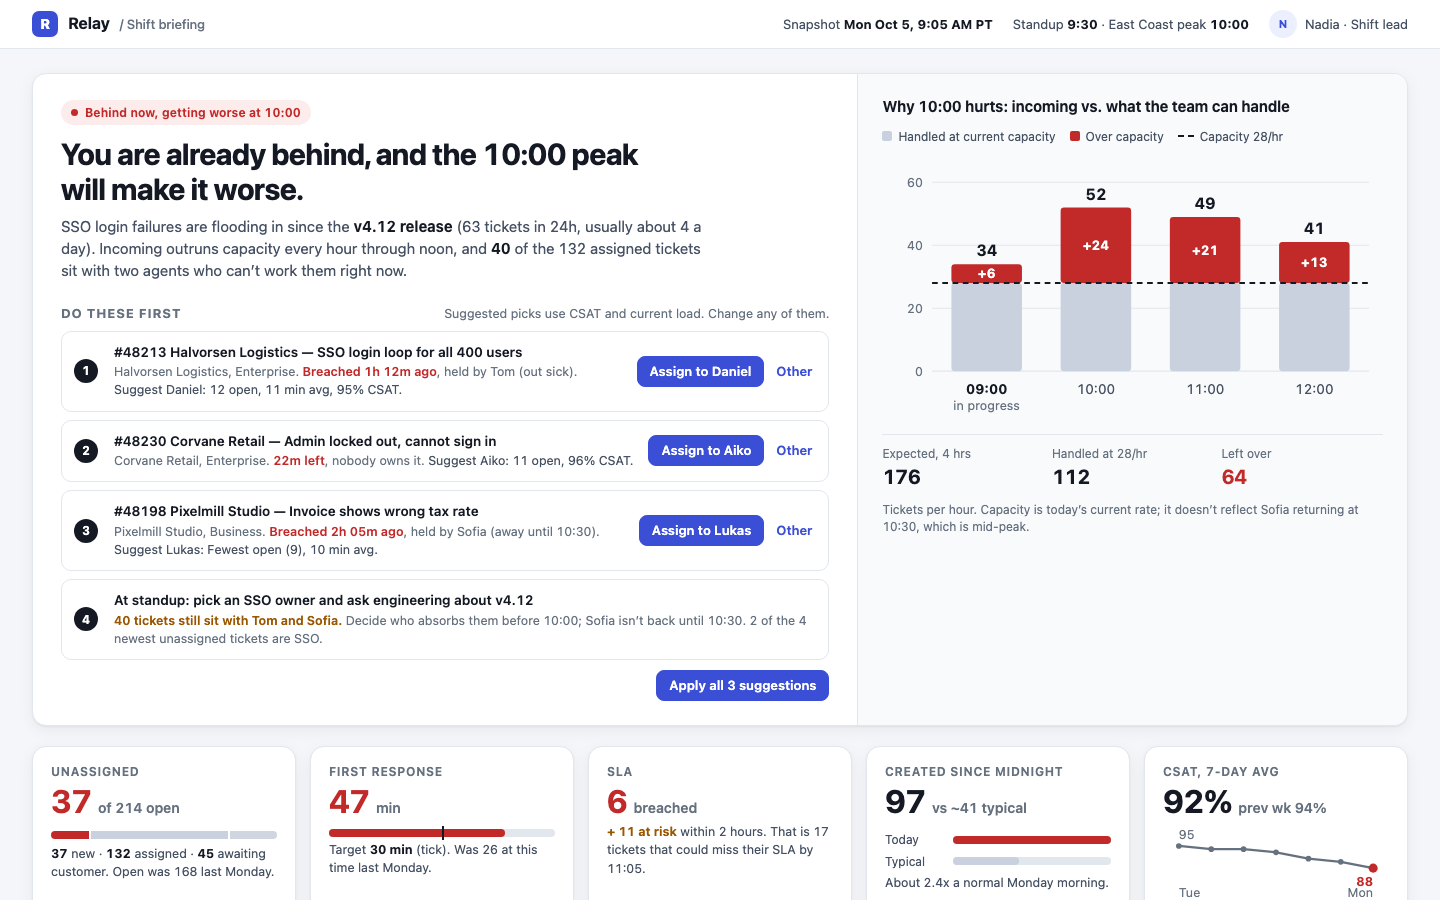
这一版,顶部先形成了一个判断:
You are already behind, and the 10:00 peak will make it worse.
你已经落后了,而 10 点的高峰会让情况更糟。
接着是 “Do these first”,再用右边的容量图解释为什么 10 点会更糟。KPI 退到了首屏下方,7 天趋势图和渠道分布没有了。
放在一起看,差别在哪里?
下面是一次场景推演,不是用户测试:我站在周一 9:05 的值班负责人的位置上,想象用这两个页面是什么感觉。
A 告诉它页面要有什么
如果我是值班负责人:“能用,数据也很全。但我得自己找重点。”
我能看到积压、SLA、容量和异常。完整总览更强,熟练的人可以自己探索和判断。
但在 9:30 就要开晨会的时候,我还得自己把几个区域拼起来:最大的风险是什么,为什么会这样,现在先处理什么。
B 告诉它用户现在需要判断什么
如果我是值班负责人:“打开以后,我很快就知道今天的问题是什么,也知道先做哪几件事。”
B 没有把所有信息都放在第一屏。它先回答:现在发生了什么,10 点为什么危险,哪些事该先做。容量图主要负责解释“为什么”。
真正变化的,是中间那几步
A 不是不能用,它更像一个完整的数据工作台。熟练的值班负责人完全可以走完这些步骤。它的代价只是:从“数据”到“可行动的 briefing”,中间的整理主要由人来完成。
A 系统把数据备好,判断主要交给人
数据 → 人自己整理 → 人自己总结 → 人自己决定
- 打开 Dashboard
- 看 KPI、SLA、容量、提示
- 自己找出今天最异常的地方
- 把几个区域的信息拼起来
- 自己整理成“9:30 要讲什么”
- 自己决定先处理什么
- 去晨会 / 执行
保留完整总览,更多探索空间,熟练的人可以自由判断
代价紧急的时候,要自己完成更多信息整合
B 页面先做一部分整理,人确认和决策
数据 → 页面先整理 → 人确认 / 调整 → 人决定
- 打开页面
- 先看到“现在最大的问题是什么”
- 看到 10:00 的风险和原因
- 看到当前该先做的几件事
- 检查证据和建议是否合理
- 确认或调整
- 去晨会 / 执行
舍弃或弱化一部分全局视角,当前不紧急的信息,一些默认的 Dashboard 模块
换来风险更直接,原因更集中,行动顺序更明确,晨会前的整理成本更低
页面已经准备好 要人自己来做
B 也不是更完整,它只是更贴近这个具体时刻要完成的任务:把一部分整理工作从人移到了页面。最终判断仍然是人做;页面只是把发现异常、聚合信息、组织 briefing、排行动优先级这些前置整理,往前推了一步。
这也是为什么我后来觉得,差别不只是视觉层级,而是前面的产品判断有没有被带进页面。
A 有自己的强项:更完整,更适合全局浏览,熟练的人也许更想保留这些信息。B 的优势来自当前任务:时间紧,马上晨会,10 点的高峰在即,要立刻调整排班和工单。为了这个任务,它主动牺牲了一部分全局完整度。
这只是这次生成里出现的差异,不是通用规律。
那我一开始猜的对吗?
回头一个个看。
视觉完成度:不是完全无关,但不像主要原因。
两版的视觉语言很接近,都是卡片、图表、告警色。B 并不是靠更多 polish,才和 A 拉开差别。
信息层级:这个猜想是对的。
B 的重点、行动顺序和证据,都更集中、更清楚。
但这又带出一个问题:为什么 B 会自然长出这样的层级?
因为 Prompt B 先交代了谁在用、为什么此刻打开、要判断什么,以及什么可以舍弃。层级是从这些里推出来的。
所以信息层级可能只是结果。更上游的,是有没有先做出一个判断:这个页面到底要帮用户判断什么。
也许“DEMO 感”不太准确
看完这两版,我反而觉得,“DEMO 感”不一定是个很准确的词。
第一版不粗糙,不难看,功能完整,单独看也挺称职。
让我觉得不同的,是它的很多选择,像是从“做一个 Dashboard”这件事里自然长出来的:KPI 一排,图表两张,表格一张,最近动态一列。
它们都有理由,却没有被谁认真排过先后。
有时所谓的 DEMO 感,更像是一种 default-output 感。
页面出来了,判断不一定做完
Vibe Coding 很容易让一句模糊的要求,迅速变成一个看起来已经完成的东西。
结果出现得太快以后,一个还没有认真决定的选择,很容易看起来像一个已经决定好的选择。
我自己的网站首页也发生过类似的事。
Hero、Featured、Recent、Series、Thinking、Projects,一个个都有理由。
放在一起,它说的是“我在做很多学习、实验和项目”。
而我真正想说的,是我怎样面对问题、做出判断,再把东西做出来。
这件事其实不只发生在 Agent 身上。给人一份模块清单,和告诉他用户此刻真正要解决什么,本来就不是同一个问题。
页面已经出来了,不代表前面的判断也已经做完了。
再往深一点
这不等于“以后 Prompt 写详细一点”就行。
Prompt B 能写出来,是因为我先想好了 Nadia 是谁、她此刻要判断什么。
如果作者自己都还不知道谁最重要、什么该删、哪个决定没做,更长的 Prompt 也不一定有用。
这时候,更有价值的 Agent,也许不是替我猜,也不是继续把 UI 做得更完整。
而是发现:
这里其实还有一个决定没有做。
然后把问题交回来。
Agent 的价值,不只是继续生成,也可能是帮我看见,还有一个决定没有被做出。
延伸阅读
The Crit:Does Your AI-Built App Look Vibe-Coded?(Nikki Kipple)
它是最初的启发来源之一,但本文的主要对照来自我自己的 Prompt experiment。